数字孪生车间的
实时监控和优化系统方案
一、背景分析
传统工业生产常受困于设备维护不足、机械故障和不当的能源资源管理,导致效率低下、反应迟缓、生产延误和成本增加,同时还造成能源和资源的大量浪费。
当前,随着工业数字化、深度学习的进步,数字孪生技术也由最初用于航天领域扩展大更广泛的制造业、汽车业等工业领域应用。在制造业中,它主要用于
创建生产设备和流程的虚拟副本,实现实时监控和预测性维护
尽管这些进步显著提高了行业的智能化水平,但目前市面上数字孪生解决方案在集成现有系统和数据交换方面仍面临挑战,并且对中小企业而言,成本可能过高且系统复杂,使得系统采用率较低。
在日益激烈的市场竞争和多样化的生产需求面前,物联网、大数据和机器学习等技术的持续进步为数字孪生技术的应用带来了新的机遇,这些技术能更好帮助企业从管理和决策端实现降本增效。
二、技术方案简述
通过构建一个高度集成的数字孪生车间监控系统,实现对车间生产过程的实时监控和优化。系统综合运用
数据采集、高级数据处理、数字孪生建模和智能决策算法
,以提高生产效率、降低能耗,并优化设备维护。
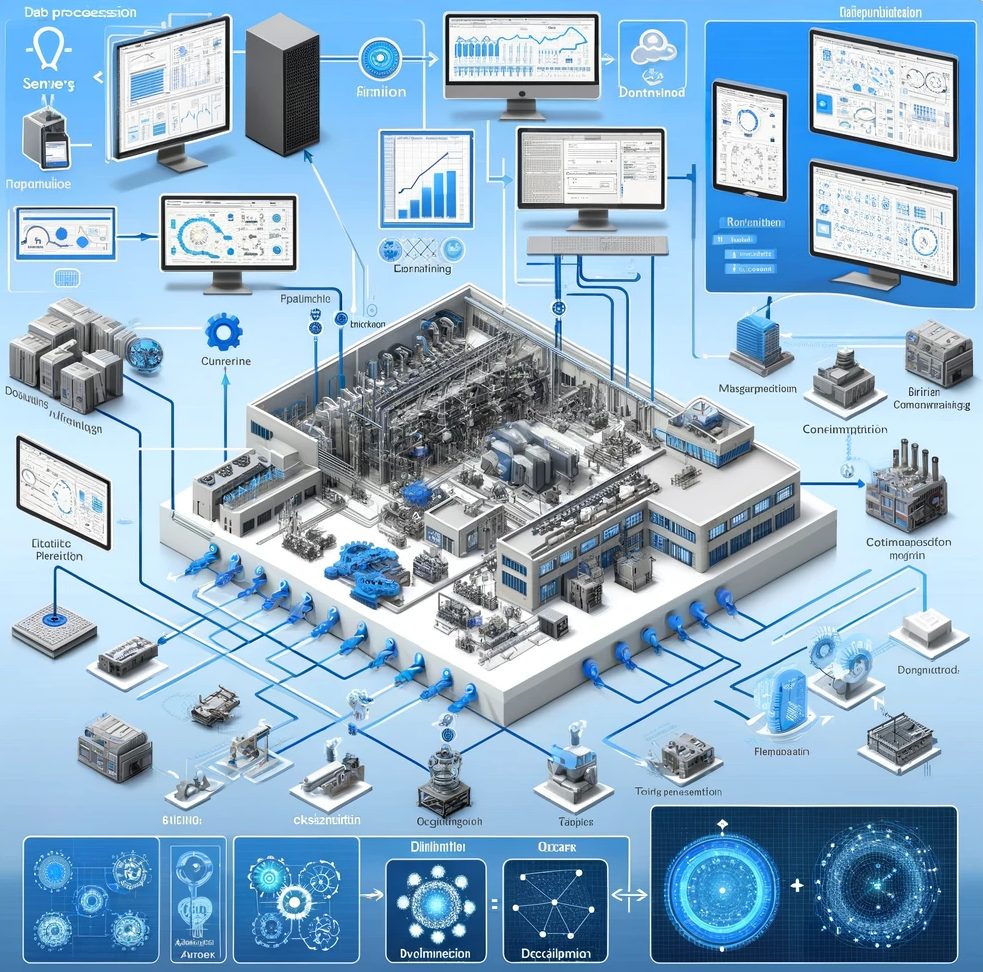
▲ 系统的总体架构,包括传感器、数据处理单元、数字孪生模型和决策算法的关系
数据采集与处理
使用多种类型的传感器(如温度传感器、压力传感器、振动传感器等)在车间各关键位置实时收集数据。
数据通过高速数据处理单元进行实时处理,使用诸如噪声过滤、数据标准化等方法来清洗数据。
特征提取部分针对生产过程中的关键参数(如设备运行时间、故障率、能耗等)进行分析,以便为后续的决策算法提供准确的输入。
数字孪生模型构建
在数字孪生模型中,创建车间的虚拟副本,包括所有机器设备和生产流程。
该模型能够实时接收来自物理车间的数据,确保虚拟环境与真实环境同步更新。
在模型中模拟不同的生产情景,进行故障诊断、流程优化等仿真实验。
优化决策算法
利用机器学习和人工智能算法对采集的数据进行深入分析,识别模式、预测趋势。
根据分析结果,系统能够提出针对生产流程、能耗管理、设备维护的优化建议。
优化算法还包括了对生产调度的动态调整,以应对订单变化、原材料供应等外部因素的影响。
用户界面与交互
开发直观易用的用户界面,实时展示车间状态、预警信息、优化建议等。
界面提供用户交互功能,使操作者能够根据系统建议或自身经验进行决策调整。
系统支持远程监控和控制,便于管理者在不同位置对车间进行管理。
安全与数据保护
系统采用先进的数据加密和访问控制技术,确保数据的安全性和隐私性。
对所有操作进行记录和审计,以防止未授权的访问和操作。
定期评估系统安全性,及时更新保护措施,应对新出现的安全威胁。
三、优化决策算法
优化决策算法中的计算公式涉及到几个关键方面,如故障预测、能耗优化、生产效率等。以下是这些方面的具体计算公式和示例代码:
1、故障预测
在故障预测模型中,通常使用分类算法来预测设备是否可能发生故障。一个简化的示例可以是逻辑回归模型,其公式如下:
其中, P(failure) 是故障发生的概率,β0,β1,...,βn是模型参数, x1,x2,...,xn 是特征值,如设备运行时间、温度波动等。
向上滑动阅览代码示例
故障预测(逻辑回归模型)
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report
# 加载数据集(假设数据集已准备好)
# X: 特征集,y: 标签集 (0: 无故障, 1: 有故障)
X, y = load_dataset() # 用适当的方法加载数据集
# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# 训练逻辑回归模型
model = LogisticRegression()
model.fit(X_train, y_train)
# 在测试集上评估模型
predictions = model.predict(X_test)
print(classification_report(y_test, predictions))
# 使用模型进行预测
new_data = np.array([new_feature1, new_feature2, ...])
predicted_probability = model.predict_proba(new_data.reshape(1, -1))[0][1]
2、能耗优化
能耗优化的目标是最小化总能耗,同时保持生产效率。可以用以下公式表示:
其中,Eopt 是优化后的总能耗, Ei 是第 i 台设备的能耗。这可能涉及到复杂的线性规划问题,根据设备的能耗特性和生产需求来调整每台设备的运行模式。
能耗优化(线性规划)
from scipy.optimize import linprog
# 定义能耗成本和生产能力
c = np.array([energy_cost1, energy_cost2, ...]) # 每台设备的能耗成本
A_eq = np.array([[production_capacity1, production_capacity2, ...]]) # 生产能力
b_eq = np.array([total_production_required]) # 总生产需求
# 添加约束条件,例如设备运行时间限制
bounds = [(min_time1, max_time1), (min_time2, max_time2), ...]
# 线性规划求解
result = linprog(c, A_eq=A_eq, b_eq=b_eq, bounds=bounds, method='highs')
# 最优能耗分布
optimal_energy_distribution = result.x
3、生产效率
生产效率可以通过比较产出和输入来衡量。公式如下:
其中,Total Output是在一定时间内的总产量,Total Input是同期内的总资源消耗,包括原材料、能源等。
def calculate_efficiency(outputs, inputs):
return np.sum(outputs) / np.sum(inputs)
# 示例数据 - 多产品多投入的情况
outputs = np.array([output1, output2, ...]) # 不同产品的产量
inputs = np.array([input1, input2, ...]) # 不同资源的投入
# 计算效率
efficiency = calculate_efficiency(outputs, inputs)
4、优化决策
在实现优化决策时,可能需要考虑多个因素的权衡,如成本、时间、质量等。这可以通过多目标优化来实现,例如:
max(w1⋅Efficiency−w2⋅Cost−w3⋅Downtime)
其中,w1、w2、w3是不同目标的权重, Efficiency 是生产效率,Cost 是生产成本, Downtime 是停机时间。
优化决策(多目标优化)
def optimize_decision(efficiency, cost, downtime, weights):
return weights[0] * efficiency - weights[1] * cost - weights[2] * downtime
# 示例数据
cost = calculate_cost(inputs) # 计算成本的函数
downtime = calculate_downtime(machines) # 计算停机时间的函数
weights = [0.5, 0.3, 0.2] # 权重
# 计算优化决策值
decision_value = optimize_decision(efficiency, cost, downtime, weights)
四、应用情况及效果
本方案通过实时监控和优化,显著提高生产效率和产品质量,减少能源消耗和运营成本,实现更可持续的生产方式。通过预测性维护减少设备停机时间,延长设备寿命。